 Server Xinchuan | Fornitore di hardware per server aziendali
Il mito: \”AI Inference Means NVIDIA\”
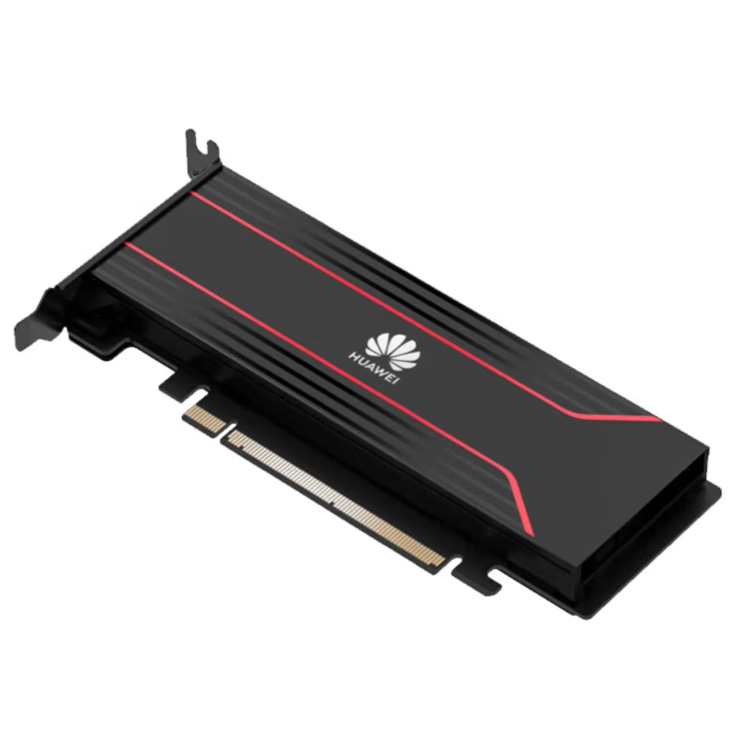
Chiedi alla maggior parte dei team di procurement di nominare un acceleratore di inferenza AI e diranno NVIDIA. Quindi chiedi loro qual è effettivamente il carico di lavoro – flussi video, classificazione delle immagini, OCR, recupero – e la risposta di solito non ha nulla a che fare con una GPU da addestramento da 700 W. IL Huawei Atlas 300V Pro esiste proprio perché gran parte dell'intelligenza artificiale di produzione è costituita dall'inferenza e dall'analisi video, dove una scheda PCIe da 72 W con codec integrati batte una GPU di data center in termini di costo per flusso, potenza per rack, e il costo totale di proprietà.
Tre miti impediscono agli acquirenti persino di valutarlo. Ecco cosa dice effettivamente la scheda tecnica.

Specifiche ufficiali
| Attributo | Specifica |
|---|---|
| Prodotto | Scheda di analisi video Atlas 300V Pro |
| Interfaccia | PCIe x16 generazione 4.0 |
| Memoria | LPDDR4X 48 GB, larghezza di banda totale 204.8 Gb/s |
| Computer IA | 140 SUPERIORI INT8 / 70 TFLOPFP16 |
| Decodifica video | H.264/H.265: 128 x1080p30 (16 x4K60); Jpeg4K 384 FPS, fino a 8192 X 8192 |
| Codifica video | H.264/H.265: 24 x1080p30 (3 x4K60); Jpeg4K 192 FPS |
| Energia | 72 W massimo |
| Temperatura operativa | 0 A 55 tu C |
| Dimensioni | 169.5 mmx 68.9 mm (Fattore di forma HHHL) |
| Peso | 280 G |
Fonte: Pagina prodotto ufficiale Huawei (e.huawei.com – Scheda di analisi video Atlas 300V Pro).
Mito 1: \”TOPS è marketing, Real Workloads Need CUDA\”
TOPS non ha senso solo se si confronta INT8 TOPS con FP32 TFLOPS. Atlas 300V Pro è una scheda video e per inferenza – suo 140 SUPERIORI INT8 / 70 TFLOPS FP16 è l'unità giusta per i carichi di lavoro di inferenza, e il suo codec H.264/H.265 integrati sono il differenziatore: 128 x flussi di decodifica 1080p30 per scheda. Un server 2U che contiene quattro di queste carte elabora 512 flussi video HD simultanei senza toccare la CPU host per il lavoro del codec. Questo è un nodo di analisi video, non una scatola GPU.
Mito 2: \”Ascend Only Runs in China\”
Atlas 300V Pro viene utilizzato ovunque il carico di lavoro sia ad alta intensità video e il budget energetico sia limitato: telecamere per città intelligenti, incroci stradali, sicurezza del campus, finanza intelligente, ispezione industriale. Lo stack software (CANNA, MindSpore, e interoperabilità ONNX/OpenVINO) esegue modelli di inferenza esportati dai framework tradizionali – la carta non richiede un ecosistema di formazione proprietario per l'implementazione.
Mito 3: \”Per 128 Flussi video, Just Buy More CPU\”
| Approccio | Hardware | Energia | Flussi |
|---|---|---|---|
| Analisi solo CPU | 2-3x nodi di calcolo 2U | 800-1500 W totale | 128 Streaming HD (Vincolato alla CPU) |
| Atlas 300V Pro | 1x scheda per ~128 stream | 72 W per carta | 128 decodifica 1080p30 + AI |
La matematica non è sottile: L'intelligenza artificiale video è un carico di lavoro con codec e inferenza, e Atlas 300V Pro fa entrambe le cose 72 W con a 48 Buffer GB (204.8 Gb/s) per contenere fotogrammi video e dati sulle funzionalità localmente. In un'implementazione di una città intelligente a 128 flussi, i risparmi energetici e di rack ripagano le carte entro il primo anno.

Architettura & Gestione
PCIe e virtualizzazione
PCIe x16 generazione 4.0 con HHHL standard (a metà, mezza lunghezza) la geometria si adatta agli slot a basso profilo dei server 1U e 2U. Il processore Ascend supporta la virtualizzazione NPU – un processore fisico può essere partizionato in NPU virtuali con 4/2/1 AI Cores per vNPU, consentire a una singola scheda di servire più VM o contenitori con capacità di inferenza isolata.
Avvio sicuro
La catena di avvio del dispositivo è completa e il suo stato iniziale è deterministico – impedendo l'iniezione di backdoor a livello del firmware. Per infrastrutture di telecamere/video soggette a pressione sulla conformità (progetti del settore pubblico, campus finanziari), L'avvio sicuro a livello hardware è un elemento di differenziazione nell'approvvigionamento che i box solo CPU non forniscono.
Fattore di forma e raffreddamento
169.5 X 68.9 mm, 280 G, 72 W massimo – raffreddato ad aria dallo chassis del server, non è richiesto alcun circuito liquido. Raggio d'azione 0-55 il grado C lo mantiene all'interno delle buste standard dei data center e degli edge cabinet.
Adattamento alla distribuzione
- Città intelligente / traffico: 128-decodifica dello streaming per scheda; accoppiare con xFusione 5288 V7 per i livelli di conservazione dei record della fotocamera.
- Città universitaria / finanza: riconoscimento del volto e della targa sul bordo con conformità di avvio sicuro.
- Inferenza insieme a NVIDIA: la scheda funziona insieme alle GPU CUDA nello stesso cluster tramite esportazioni ONNX/OpenVINO – è additivo, non esclusivo. Confronta le taglie con le NVIDIA L40S (48GB) per pura inferenza LLM rispetto a profili di analisi video.
Domande frequenti sull'acquisto
- Formazione o inferenza? Inferenza e analisi video. I carichi di lavoro di formazione appartengono agli acceleratori di classe A100/H100.
- Quali server si adattano? Qualsiasi slot HHHL PCIe x16 Gen4 – 1Server rack U/2U di xFusion, Dell e Huawei.
- Quanti flussi per scheda? 128 x decodifica 1080p30 H.264/H.265, 24 codifica x 1080p30.
- Supporto software? CANNA + Ecosistema MindSpore con interoperabilità ONNX/OpenVINO per i modelli distribuiti.
- Garanzia? competitive supply with 3-year warranty and global shipping from our direct channel.
Analisi dell'inferenza video-AI? As an independent supplier of Huawei and xFusion hardware we supply the Atlas 300V Pro with competitive pricing, 3-anno di garanzia, spedizione globale e consulenza gratuita sul dimensionamento per flusso – sfogliare i nostri prodotti O contattaci per una configurazione personalizzata.